文章目錄
10 月 22 日,微軟在《Science》期刊發表了他們的診斷 AI:MAI-DxO(Microsoft AI Diagnostic Orchestrator)。在一批出了名難的病例上,它答對的比例是一般科醫師的兩倍以上。這幾天社群上討論得很熱。
大部分討論集中在準確率。我們比較好奇的是,它到底是怎麼看病的?所以把微軟的官方說明、論文前身的預印本,還有幾篇報導都讀了一遍,用白話整理在這裡。
以前的醫療 AI,大多在考選擇題
過去幾年常看到「AI 通過美國醫師執照考試」的新聞。這類考試會把病人的主訴、病史、檢查結果一次寫好,最後選一個答案。
但真的看病不是這樣。病人走進診間時,醫生手上可能只有一兩句話,接下來要問什麼、驗什麼、什麼時候下判斷,都得自己決定。微軟團隊在 2025 年的預印本裡就提到,選擇題式的測驗容易高估模型,也看不出「太早下結論」或「什麼都驗一輪」這類問題。
所以他們做了一套新的考法,叫 SDBench(Sequential Diagnosis Benchmark,逐步診斷測驗):
- 題目:304 個《新英格蘭醫學期刊》(NEJM)的疑難病例討論;Science 正式版另外加入了美國急診的常見病例(MIMIC-IV-ED)。
- 開場:只給兩三句病人簡介,例如「29 歲女性,喉嚨痛、扁桃腺周圍腫脹出血,用了抗生素也沒好」。
- 過程:想知道更多就得開口問,或開檢查。另一個 AI 扮演「守門員」,問到什麼才回答什麼,問得太籠統會被拒絕。
- 計分:最後由「評審」AI 對照正確診斷打分,同時把一路開過的檢查換算成費用。
也就是說,這套考法看的不只是答案對不對,還有過程合不合理、花了多少錢。
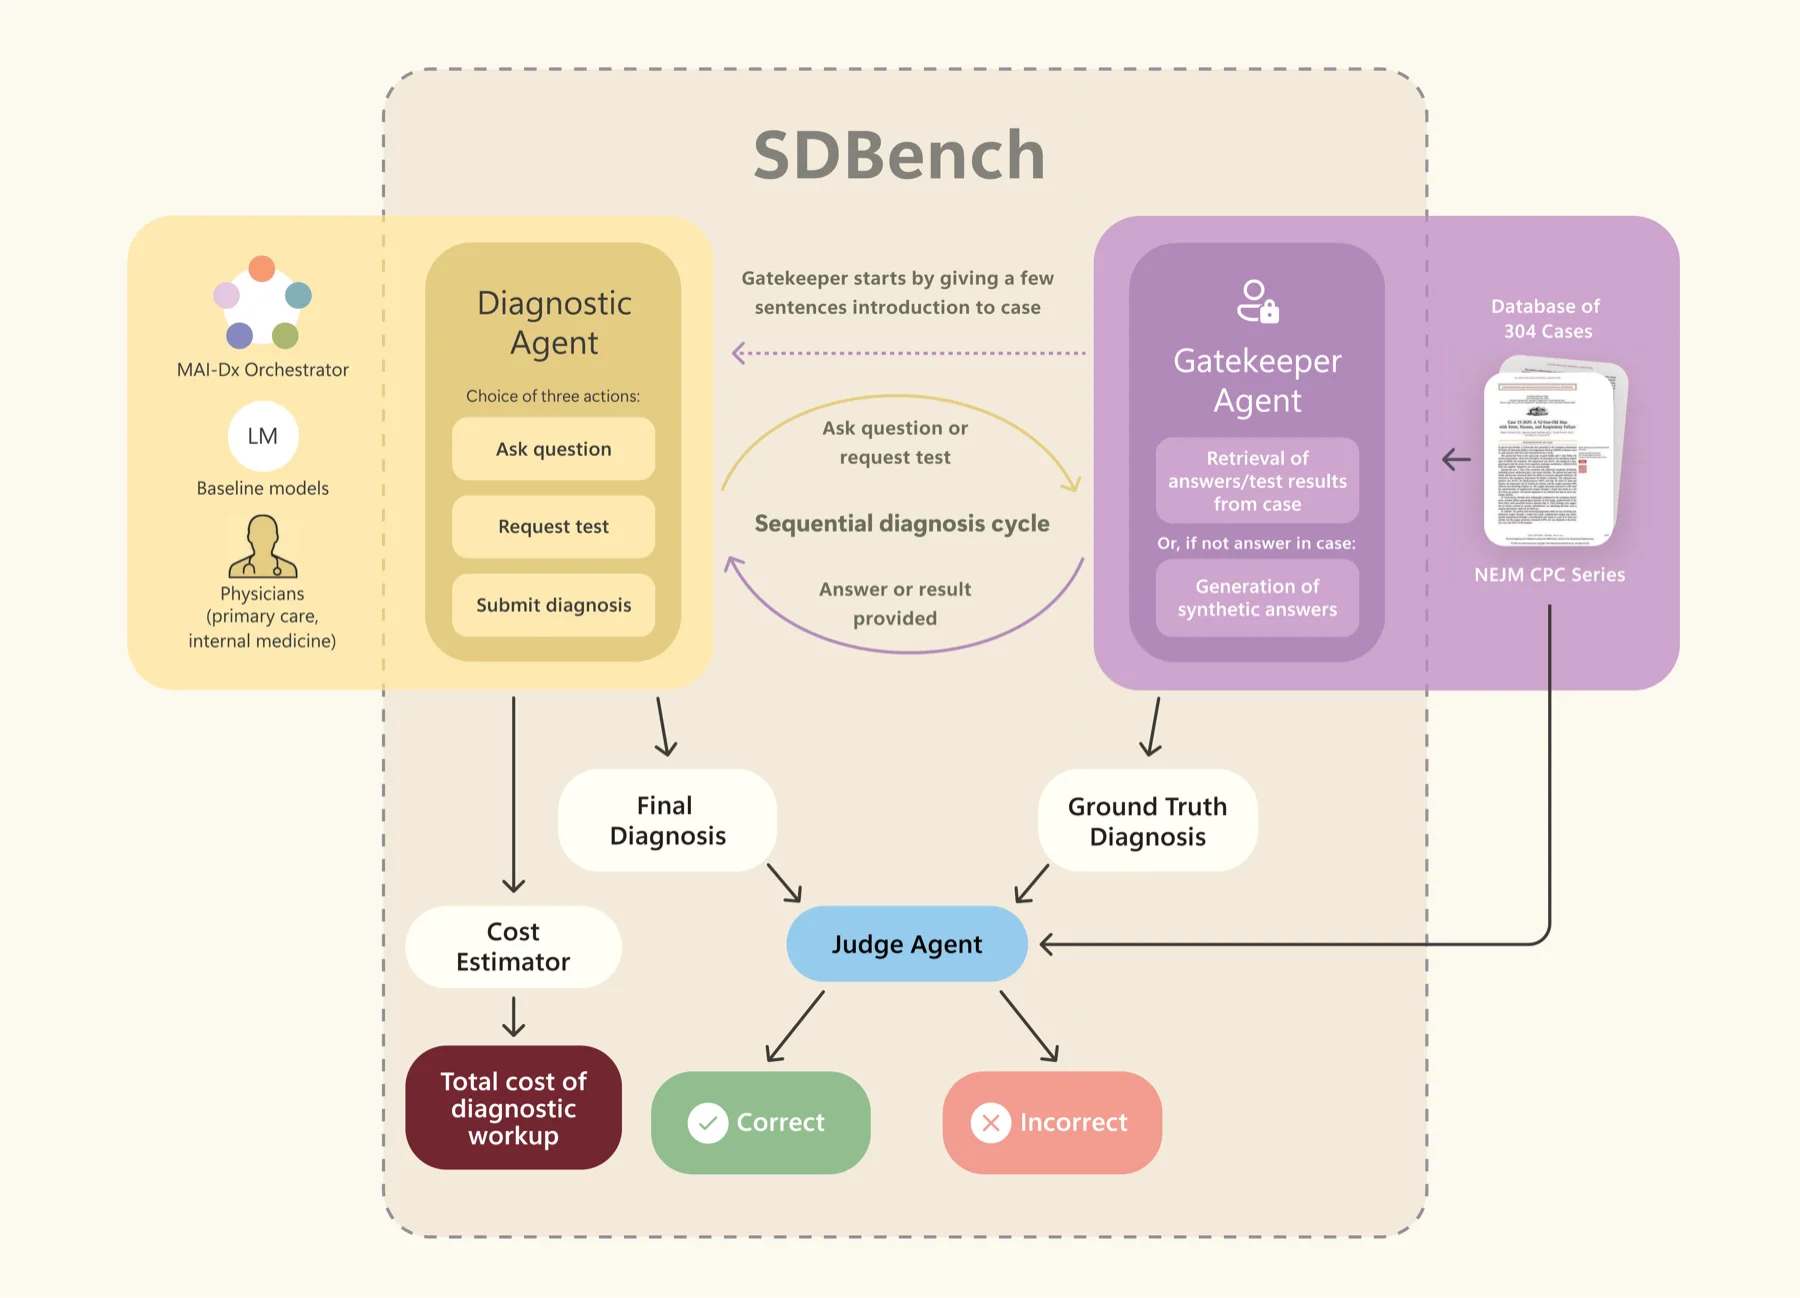
圖:SDBench 的逐步診斷流程。圖片來源:Microsoft SDBench(© Microsoft Corporation,MIT License)
MAI-DxO 怎麼看病:一個 AI 分飾五個醫生
MAI-DxO 不是單獨一個新模型。它是一套「協作架構」,讓同一個語言模型輪流扮演不同角色,像一個小型會診團隊。依 2025 年預印本的描述,團隊裡有五個角色:
| 角色 | 負責什麼 |
|---|---|
| 假設醫師(Dr. Hypothesis) | 列出最可能的三個診斷,每拿到新資訊就更新機率 |
| 選檢查醫師(Dr. Test-Chooser) | 每一輪挑最多三項最能區分這些可能的檢查 |
| 唱反調醫師(Dr. Challenger) | 找出先入為主的地方和矛盾的證據,提議能推翻目前判斷的檢查 |
| 管成本醫師(Dr. Stewardship) | 效果差不多就選便宜的,否決又貴又沒幫助的檢查 |
| 品管醫師(Dr. Checklist) | 確認檢查名稱寫得正確,團隊前後推理一致 |
五個角色討論完(論文叫它「辯論鏈」),團隊只能做三件事之一:問病人問題、開檢查,或是有把握了就下診斷。拿到新資訊後再討論一輪,直到確定為止。
預印本裡有個例子很能說明差別。一位因酒精戒斷住院的病人,誤喝了乾洗手而中毒。直接把病例丟給模型時,它一直往抗生素副作用的方向想,開了腦部 MRI、腦波等貴的檢查,最後還是猜錯,花了 3,431 美元。換成 MAI-DxO,假設醫師在第一輪就提醒要考慮住院期間接觸到的毒物,團隊先問了病人有沒有喝乾洗手。病人承認後,只做了針對性的檢查就確診,總共花 795 美元。
先問、再驗,問對問題往往比多做檢查更有用。這其實也是很多資深醫師在做的事。
成績:疑難病例兩倍以上,急診案例 1.7 倍
微軟公布的 Science 正式版結果如下:
| 病例來源 | MAI-DxO | 醫師 |
|---|---|---|
| NEJM 疑難病例(304 例) | 83% | 36%(可查教科書、網路)/22%(不可查) |
| 美國急診常見病例(MIMIC-IV-ED) | 80% | 47% |
換算下來,在疑難病例上大約是醫師的 2.3 倍(可查資料)到 3.7 倍(不可查資料);急診案例則是 1.7 倍多。新聞標題常見的「近 4 倍」,指的是後者。
成本方面,微軟表示 MAI-DxO 能用一半甚至三分之一的檢查費用找到正確診斷。其中一個偏重省錢的設定,在疑難病例上仍有 81% 的準確率。在兩組病例裡,都沒有其他人類或 AI 的做法同時比它更準又更便宜。
另外要注意:2025 年預印本的數字(MAI-DxO 最高 85.5%,醫師平均 20%)跟正式版不同,網路上有些文章還在用舊數字。
看數字時,可以多想三件事
這些成績很亮眼,研究團隊自己也很清楚它的適用範圍。讀數字時可以把這三點一起放進來。
1. 比的是一般科醫師,不是專科團隊。參與比較的是家醫科與一般內科醫師。這麼難的病例,現實中通常會轉給專科或由醫療團隊處理。研究團隊在預印本裡也提出了這個問題:評估 AI 時,該跟單一醫師比,還是跟整個醫院的團隊比?
2. 目前還是模擬。病例來自已發表的病例討論,病人的回答由 AI 守門員代為提供。NEJM 的病例都是挑過的難題,裡面沒有健康或輕症的人,所以還不知道它在日常常見病上表現如何。檢查費用則是用美國醫院的價格估算的。
3. 底層模型的貢獻很大。TechCrunch 整理了論文數據:GPT-5 單獨作答就有 78.9%,套上 MAI-DxO 後準確率多約 4 個百分點,每例成本少約 3,000 美元;換成 GPT-5.5,疑難病例從 72% 提升到近 87%;急診案例則加不加架構都在 85% 左右。微軟的說法是,換用新模型後不必改協作方法,增益依然存在。預印本也提到,這套架構不綁定特定模型,醫院不用每出一個新模型就從頭來過。
下一步:從考場走進醫院
微軟接下來要和波士頓的貝斯以色列女執事醫療中心(BIDMC)做前瞻性研究,範圍包括急診和緊急照護。病人一樣接受原本的檢傷、看診和治療;同意參與的人,會另外跟 MAI-DxO 互動,最後比對 AI 的建議和醫師的判斷。微軟醫療副總裁 Dominic King 說,他們認為這會是同類研究中規模最大的一個。
其他幾件同時在進行的事:
- 開源:微軟會開源 SDBench 的部分 NEJM 病例,連同守門員、評審和成本估算的程式碼,讓其他研究者重現、挑戰或延伸這項研究。
- 醫療基礎模型:微軟正和 Mayo Clinic 合作訓練醫療專用的基礎模型,預計明年推出。
- 同業也在做:Google 這個月也和 BIDMC 在《The Lancet》發表研究,在真實的緊急照護門診裡評估他們的對話式診斷 AI「AMIE」,過程由醫師即時監看。
接下來一兩年,各家在真實醫院的研究結果會陸續出來,這些會比考試成績更有參考價值。
參考資料
- Building Medical Superintelligence,Microsoft AI,2026-10-22
- Sequential diagnosis 論文(Science),2026-10-22
- Sequential Diagnosis with Language Models(arXiv 預印本),Microsoft AI,2025
- Microsoft’s Mustafa Suleyman says its AI outperforms doctors on hard cases,TechCrunch,2026-10-22
- SDBench 開源頁面
相關文章:AI 接進病歷系統:2026 年美國與台灣醫院的兩條路 · 台灣醫療 AI 的真正轉折點:從試點到臨床,Agentic AI 正在重寫遊戲規則
討論區 (0 則留言)